Random Forest Classification
import pandas as pd
import numpy as np
import seaborn as sns
Loading the data set:
df=sns.load_dataset("penguins")
df.head()
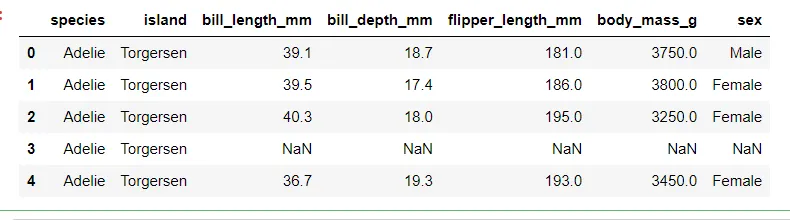
df.shape
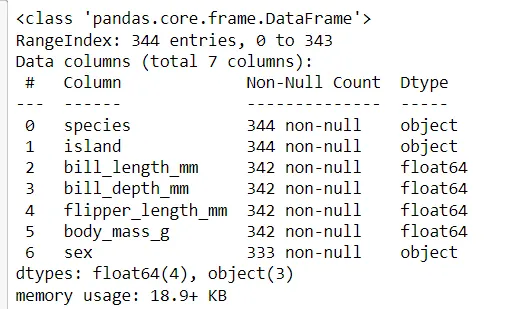
df.info()
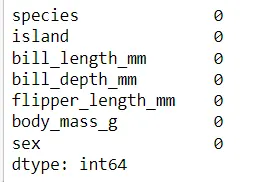
df.isnull().sum()
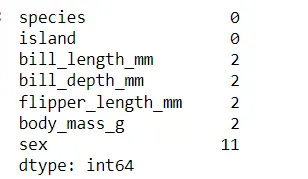
Drop Null Values:
df.dropna(inplace=True)
df.isnull().sum()
Feature Engineering:
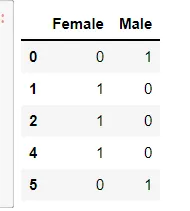
One hot encoding transforming categorical data into numeric
df.sex.unique()
pd.get_dummies(df['sex']).head()
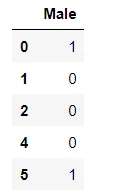
sex=pd.get_dummies(df['sex'],drop_first=True)
sex.head()
Applying one-hot encoding to island:
df.island.unique()
pd.get_dummies(df['island']).head()
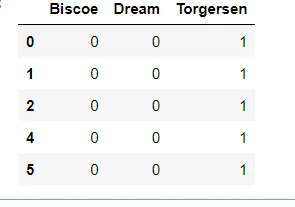
island=pd.get_dummies(df['island'],drop_first=True)
island.head()
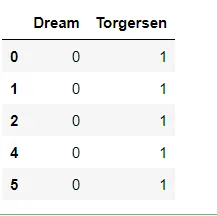
Concatenate the above two data frames to the original df:
new_data=pd.concat([df,island,sex],axis=1)
new_data.head()
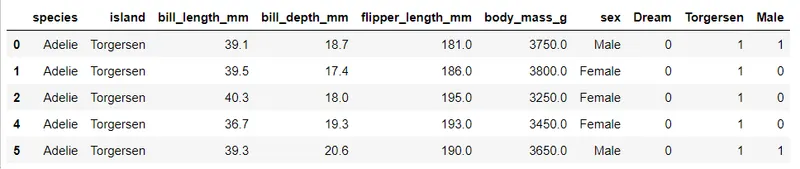
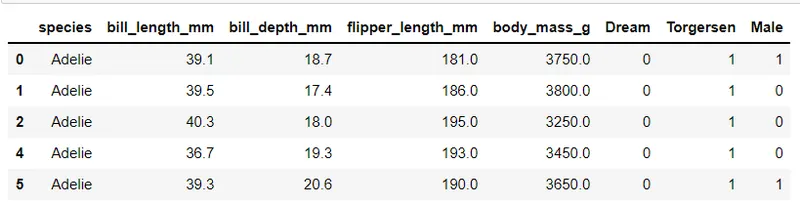
Drop Repeated columns:
new_data.drop(['sex','island'],axis=1,inplace=True);
new_data.head()
Creating separate target variables:
Y= new_data.species
Y.head()
Y.unique()
Y=Y.map({'Adelie':0, 'Chinstrap':1, 'Gentoo':2}) # Using map function to convert categorial values into numeric
Y.head()
Dropping the Target variables: Species:
new_data.drop('species',inplace=True,axis=1)
new_data.head()
X=new_data
Splitting the data into training and test data:
from sklearn.model_selection import train_test_split
X_train, X_test, Y_test,Y_train = train_test_split(X,Y,test_size=0.3,random_state=0)
print('X_train',X_train.shape)
print('X_test',X_test.shape)
print('Y_train',Y_train.shape)
print('Y_test',Y_test.shape)
Training Random Forest classification on the training set:
from sklearn.ensemble import RandomForestClassifier
classifier = RandomForestClassifier(n_estimators=4,criterion='gini',random_state=0)
classifier.fit(X_train,Y_test)
Predicting the test results:
y_pred=classifier.predict(X_test)
y_pred
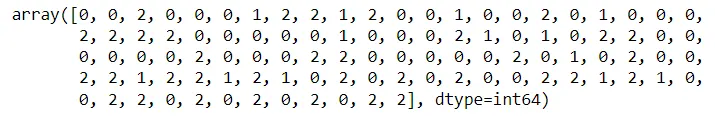
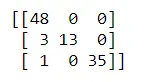
Confusion matrix:
from sklearn.metrics import confusion_matrix
from sklearn.metrics import classification_report,accuracy_score
cm=confusion_matrix(Y_train,y_pred)
print(cm)
accuracy_score(Y_train,y_pred)
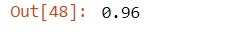
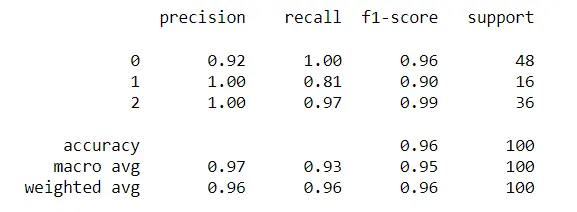
print(classification_report(Y_train,y_pred))
Try different number of trees and entropy criteria:
from sklearn.ensemble import RandomForestClassifier
classifier = RandomForestClassifier(n_estimators=4,criterion='entropy',random_state=0)
classifier.fit(X_train,Y_test)
y_pred=classifier.predict(X_test)
accuracy_score(Y_train,y_pred)