Project 2 - EDA on Vehicle Insurance Customer Data
1. Add the column names to both datasets:
i. Column Name for customer details table:
cd = (cd.rename(columns = {'0' : 'customer_id', '1' : 'Gender', '2' : 'age', '3' : 'driving license present', '4' : 'region code',
'5' : 'previously insured', '6' : 'vehicle age', '7' : 'vehicle damae in '} ))
ii. Column Name for customer_policy table:
cp = (cp.rename(columns = {'0' : 'customer_id', '1' : 'annual premium', '2' : 'sales channel code',
'3' : 'vintage', '4' : 'response'}))
2. Checking and Cleaning Data Quality:
i. Null values
a. Generate a summary of count of all the null values column wise
cd.isnull().sum()
customer_id                386
Gender                     368
age                        368
driving license present    393
region code                392
previously insured         381
vehicle age                381
vehicle damae in           407
dtype: int64
cp.isnull().sum()
customer_id             387
annual premium          346
sales channel code      400
vintage and response    388
response                361
dtype: int64
b. Drop Null values for customer_id because central tendencies for id’s is not feasible.
cd = cd.dropna(subset = ['customer_id'])
cp = cp.dropna(subset = ['customer_id'])
c. Replace all null values for numeric columns by mean.
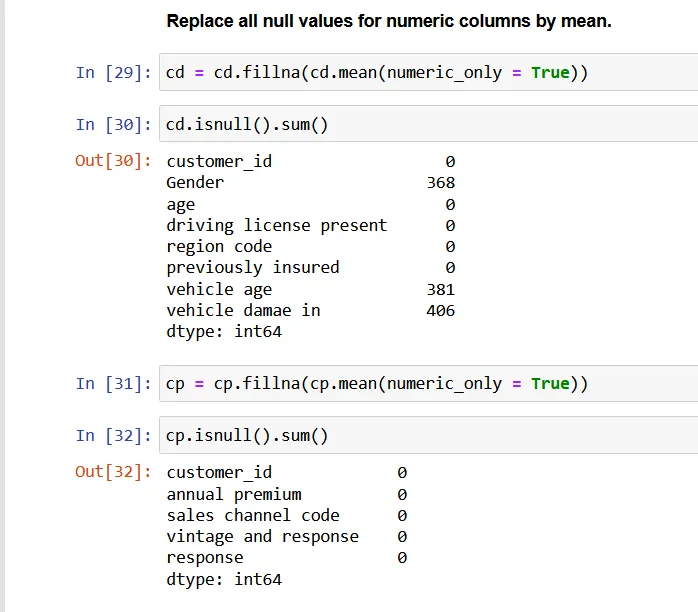
d. Replace all null values for Categorical value by mode.
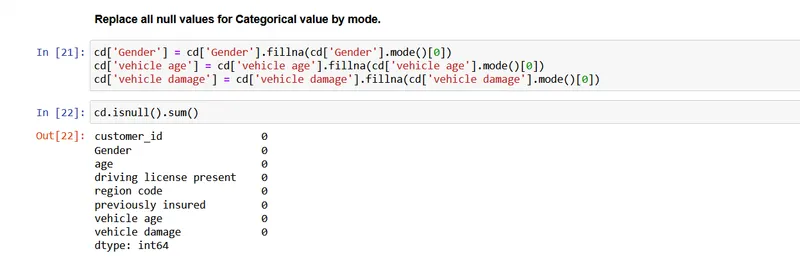
ii. Outliers
a. Generate a summary of count of all the outliers column wise
def outlier_IQR(df):
q1 = df.quantile(0.25)
q3 = df.quantile(0.75)
IQR = q3 - q1
outliers = df[((df<(q1-1.5*IQR)) | (df>(q3+1.5*IQR)))]
return outliers
outliers = outlier_IQR(cd['customer_id'])
a = outliers.value_counts().sum()
outliers1 = outlier_IQR(cd['age'])
b = outliers.value_counts().sum()
outliers2 = outlier_IQR(cd['driving license present'])
c = outliers.value_counts().sum()
outliers3 = outlier_IQR(cd['region code'])
d = outliers.value_counts().sum()
outliers4 = outlier_IQR(cd['previously insured'])
e = outliers.value_counts().sum()
outliers_cd = pd.DataFrame([a,b,c,d,e], ['customer_id', 'age', 'driving license present', 'region code', 'previously insured'], columns = ['no of outliers'])
outliers_cd
outliers = outlier_IQR(cp['customer_id'])
a = outliers.value_counts().sum()
outliers1 = outlier_IQR(cp['annual premium'])
b = outliers.value_counts().sum()
outliers2 = outlier_IQR(cp['sales channel code'])
c = outliers.value_counts().sum()
outliers3 = outlier_IQR(cp['vintage'])
d = outliers.value_counts().sum()
outliers4 = outlier_IQR(cp['response'])
e = outliers.value_counts().sum()
outliers_cp = pd.DataFrame([a,b,c,d,e], ['customer_id', 'annual premium', 'sales channel code', 'vintage', 'response'], columns = ['no of outliers'])
outliers_cp
b. Replace all outlier values for numeric columns by mean.
def replace_outliers(df):
q1=df.quantile(0.25)
q3=df.quantile(0.75)
IQR=q3-q1
upper = df[~(df>(q3+1.5*IQR))].max()
lower = df[~(df<(q1-1.5*IQR))].min()
df = np.where(df > upper, df.mean(),np.where(df < lower,df.mean(),df))
return df
replace_outliers(cd['driving license present'])
replace_outliers(cp['annual premium'])
replace_outliers(cp['response'])
iii. White spaces
a. Remove white spaces
cd['Gender'].str.strip()
0           Male
1           Male
2           Male
3           Male
4         Female
           ...
381104      Male
381105      Male
381106      Male
381107    Female
381108      Male
Name: Gender, Length: 380723, dtype: object
iv. case correction(lower or upper, any one)
cd.apply(lambda x:x.astype(str).str.upper())
v. Convert nominal data (categorical) into dummies
gender_dummy = pd.get_dummies(cd['Gender'])
gender_dummy
vehicle_age_dummy = pd.get_dummies(cd['vehicle age'])
vehicle_age_dummy
vehicle_age_dummy = pd.get_dummies(cd['vehicle age'])
vehicle_age_dummy
vi. Drop Duplicates (duplicated rows)
cd = cd.drop_duplicates()
cd
cp = cp.drop_duplicates()
cp
3. Create a Master table for future use. Join the customer table and customer_policy table to get a master table using customer_id in both tables.
Master_Table = pd.merge(cd, cp, on = 'customer_id')
Master_Table
| customer_id | Gender | age | driving license present | region code | previously insured | vehicle age | vehicle damage | annual premium | sales channel code | vintage | response | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1.0 | Male | 44.0 | 1.0 | 28.0 | 0.0 | > 2 Years | Yes | 40454.0 | 26.0 | 217.0 | 1.0 |
| 1 | 2.0 | Male | 76.0 | 1.0 | 3.0 | 0.0 | 1-2 Year | No | 33536.0 | 26.0 | 183.0 | 0.0 |
| 2 | 3.0 | Male | 47.0 | 1.0 | 28.0 | 0.0 | > 2 Years | Yes | 38294.0 | 26.0 | 27.0 | 1.0 |
| 3 | 4.0 | Male | 21.0 | 1.0 | 11.0 | 1.0 | < 1 Year | No | 28619.0 | 152.0 | 203.0 | 0.0 |
| 4 | 5.0 | Female | 29.0 | 1.0 | 41.0 | 1.0 | < 1 Year | No | 27496.0 | 152.0 | 39.0 | 0.0 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 380331 | 381105.0 | Male | 74.0 | 1.0 | 26.0 | 1.0 | 1-2 Year | No | 30170.0 | 26.0 | 88.0 | 0.0 |
| 380332 | 381106.0 | Male | 30.0 | 1.0 | 37.0 | 1.0 | < 1 Year | No | 40016.0 | 152.0 | 131.0 | 0.0 |
| 380333 | 381107.0 | Male | 21.0 | 1.0 | 30.0 | 1.0 | < 1 Year | No | 35118.0 | 160.0 | 161.0 | 0.0 |
| 380334 | 381108.0 | Female | 68.0 | 1.0 | 14.0 | 0.0 | > 2 Years | Yes | 44617.0 | 124.0 | 74.0 | 0.0 |
| 380335 | 381109.0 | Male | 46.0 | 1.0 | 29.0 | 0.0 | 1-2 Year | No | 41777.0 | 26.0 | 237.0 | 0.0 |
380336 rows × 12 columns
4. Company needs some important information from the master table to make decisions for future growth.They needs following information:
i. Gender wise average annual premium
Master_Table.groupby('Gender')['annual premium'].mean()
Gender
Female    30492.028478
Male      30623.619273
Name: annual premium, dtype: float64
ii. Age wise average annual premium
Master_Table.groupby('age')['annual premium'].mean()
age
20.0    26924.620173
21.0    30564.475810
22.0    30823.778102
23.0    30688.606298
24.0    31183.802890
            ...
81.0    31201.571429
82.0    37705.379310
83.0    31012.727273
84.0    35440.818182
85.0    29792.363636
Name: annual premium, Length: 67, dtype: float64
iii. Is your data balanced between the genders?
if Master_Table.groupby('Gender')['annual premium'].mean().value_counts().iloc[0] == Master_Table.groupby('Gender')['annual premium'].mean().value_counts().iloc[1]:
print('Data is balanced gender wise')
else:
print('Data is not balance gender wise')
iv. Vehicle age wise average annual premium.
Master_Table.groupby('vehicle age')['annual premium'].mean()
vehicle age
1-2 Year     30524.629840
< 1 Year     30115.716367
> 2 Years    35657.520845
Name: annual premium, dtype: float64
5. Is there any relation between Person Age and annual premium?
Correlation_coefficient = Master_Table['age'].corr(Master_Table['annual premium'])
Correlation_coefficient
if Correlation_coefficient < -0.5:
print("Strong negative relationship")
elif Correlation_coefficient > 0.5:
print("Strong positive relationship")
elif -0.5 < Correlation_coefficient < 0.5:
print("There is no relationship. ")