Project
TASK 1:
import cv2
import numpy as np
import matplotlib.pyplot as plt
image1 = cv2.imread('A01_1.jpg', cv2.IMREAD_GRAYSCALE)
image2 = cv2.imread('A01_2.jpg', cv2.IMREAD_GRAYSCALE)
mask1 = cv2.imread('feature_mask.png', cv2.IMREAD_GRAYSCALE)
mask2 = cv2.imread('mask.png', cv2.IMREAD_GRAYSCALE)
def load_control_points(file_path):
points = np.loadtxt(file_path)
return points
control_points1 = load_control_points('control_points_A01_1_2.txt')
control_points2 = load_control_points('control_points_A02_1_2.txt')
plt.figure(figsize=(12, 12))
plt.subplot(2, 2, 1)
plt.title('Image 1')
plt.imshow(image1, cmap='gray')
plt.subplot(2, 2, 2)
plt.title('Image 2')
plt.imshow(image2, cmap='gray')
plt.subplot(2, 2, 3)
plt.title('Mask 1')
plt.imshow(mask1, cmap='gray')
plt.subplot(2, 2, 4)
plt.title('Mask 2')
plt.imshow(mask2, cmap='gray')
plt.show()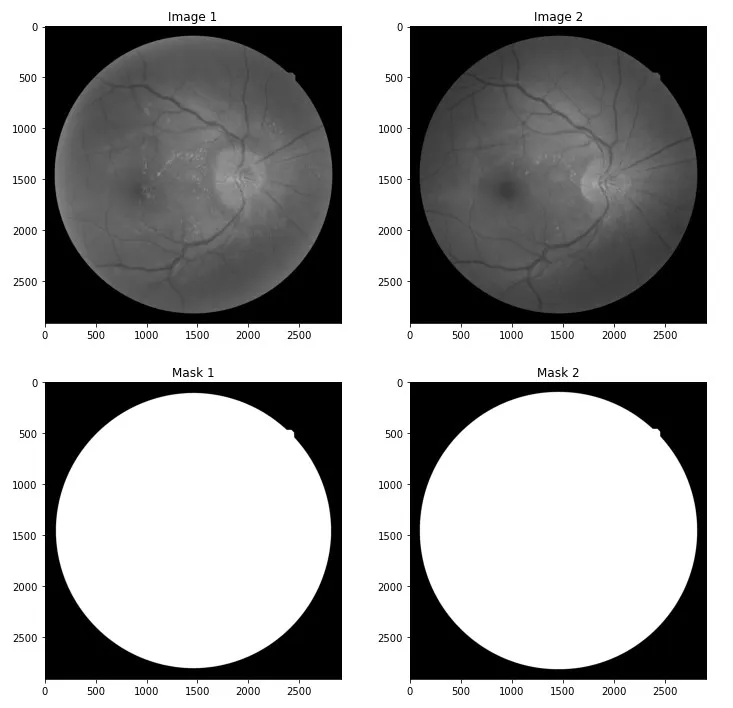
def register_images_with_control_points(image1, image2, control_points1, control_points2):
src_pts = control_points1[:, :2]
dst_pts = control_points2[:, :2]
M, mask = cv2.findHomography(dst_pts, src_pts, cv2.RANSAC, 5.0)
# Warp the second image to align it with the first image
h, w = image1.shape
aligned_image = cv2.warpPerspective(image2, M, (w, h))
return aligned_image, M
aligned_image, M = register_images_with_control_points(image1, image2, control_points1, control_points2)
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1)
plt.title('Aligned Image')
plt.imshow(aligned_image, cmap='gray')
plt.subplot(1, 2, 2)
plt.title('Mask 1')
plt.imshow(mask1, cmap='gray')
plt.show()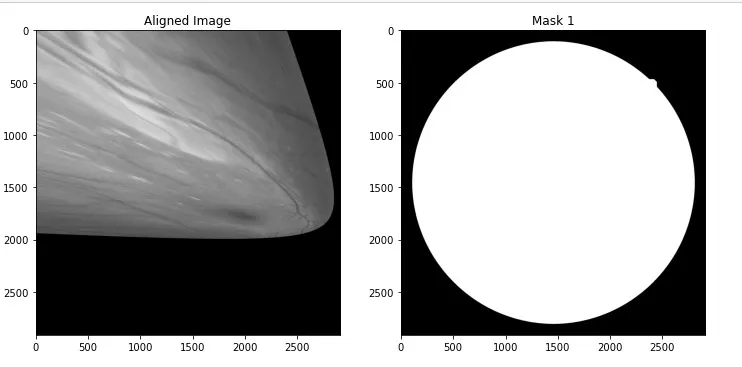
aligned_mask2 = cv2.warpPerspective(mask2, M, (image1.shape[1], image1.shape[0]))
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1)
plt.title('Aligned Mask 2')
plt.imshow(aligned_mask2, cmap='gray')
plt.subplot(1, 2, 2)
plt.title('Mask 1')
plt.imshow(mask1, cmap='gray')
plt.show()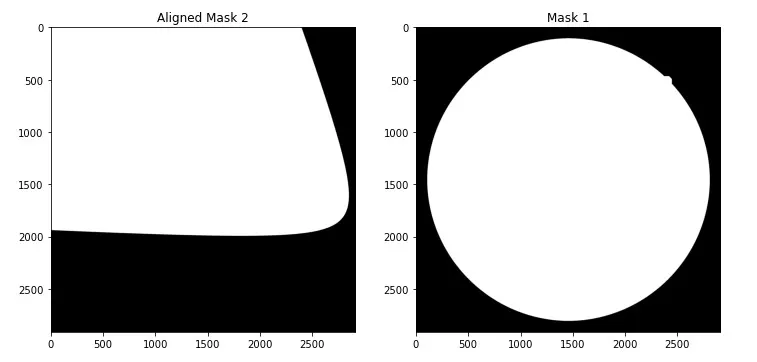
from skimage.metrics import mean_squared_error, structural_similarity
mse = mean_squared_error(mask1, aligned_mask2)
ssim, _ = structural_similarity(mask1, aligned_mask2, full=True)
print(f'Mean Squared Error: {mse}')
print(f'Structural Similarity Index: {ssim}')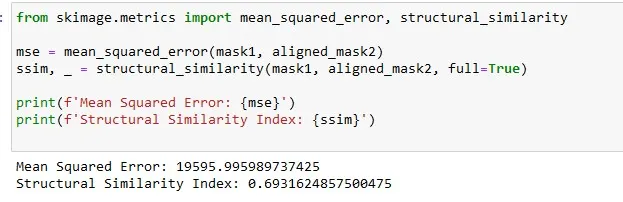
TASK 2:
from google.colab import files
# Upload the dataset files
uploaded = files.upload()
import os
import cv2
import torch
import numpy as np
import pandas as pd
from torch.utils.data import Dataset, DataLoader
from torchvision import models, transforms
import albumentations as A
from albumentations.pytorch import ToTensorV2
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, f1_score
import matplotlib.pyplot as plt
# After uploading, the files will be in the current working directory of the Colab environment
# List the files to check
print(os.listdir())
# Load labels
labels_df = pd.read_csv('trainLabels.csv')
# Define the augmentation pipeline
train_transforms = A.Compose([
A.RandomResizedCrop(width=224, height=224),
A.HorizontalFlip(p=0.5),
A.RandomBrightnessContrast(p=0.2),
A.ShiftScaleRotate(shift_limit=0.05, scale_limit=0.1, rotate_limit=15, p=0.5),
A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2()
])
valid_transforms = A.Compose([
A.Resize(width=224, height=224),
A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
ToTensorV2()
])
class RetinopathyDataset(Dataset):
def __init__(self, image_dir, labels_df, transform=None):
self.image_dir = image_dir
self.labels_df = labels_df
self.transform = transform
def __len__(self):
return len(self.labels_df)
def __getitem__(self, idx):
img_name = os.path.join(self.image_dir, self.labels_df.iloc[idx, 0] + '.jpeg')
image = cv2.imread(img_name)
image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
label = self.labels_df.iloc[idx, 1]
if self.transform:
augmented = self.transform(image=image)
image = augmented['image']
return image, label
image_dir = './'
train_df, valid_df = train_test_split(labels_df, test_size=0.2, stratify=labels_df['level'], random_state=42)
train_dataset = RetinopathyDataset(image_dir, train_df, transform=train_transforms)
valid_dataset = RetinopathyDataset(image_dir, valid_df, transform=valid_transforms)
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True, num_workers=4)
valid_loader = DataLoader(valid_dataset, batch_size=32, shuffle=False, num_workers=4)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = models.resnet50(pretrained=True)
model.fc = torch.nn.Linear(model.fc.in_features, 5) # Assuming 5 classes for diabetic retinopathy
model = model.to(device)
# Defining loss function and optimizer
criterion = torch.nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4)
def train_model(model, train_loader, valid_loader, criterion, optimizer, num_epochs=25):
best_model_wts = None
best_acc = 0.0
for epoch in range(num_epochs):
print(f'Epoch {epoch}/{num_epochs - 1}')
print('-' * 10)
# Each epoch has a training and validation phase
for phase in ['train', 'val']:
if phase == 'train':
model.train() # Set model to training mode
data_loader = train_loader
else:
model.eval() # Set model to evaluate mode
data_loader = valid_loader
running_loss = 0.0
running_corrects = 0
# Iterate over data
for inputs, labels in data_loader:
inputs = inputs.to(device)
labels = labels.to(device)
# Zero the parameter gradients
optimizer.zero_grad()
# Forward
with torch.set_grad_enabled(phase == 'train'):
outputs = model(inputs)
_, preds = torch.max(outputs, 1)
loss = criterion(outputs, labels)
# Backward + optimize only if in training phase
if phase == 'train':
loss.backward()
optimizer.step()
# Statistics
running_loss += loss.item() * inputs.size(0)
running_corrects += torch.sum(preds == labels.data)
epoch_loss = running_loss / len(data_loader.dataset)
epoch_acc = running_corrects.double() / len(data_loader.dataset)
print(f'{phase} Loss: {epoch_loss:.4f} Acc: {epoch_acc:.4f}')
# Deep copy the model
if phase == 'val' and epoch_acc > best_acc:
best_acc = epoch_acc
best_model_wts = model.state_dict()
print(f'Best val Acc: {best_acc:4f}')
# Loading best model weights
if best_model_wts is not None:
model.load_state_dict(best_model_wts)
return model
# Training the model
model = train_model(model, train_loader, valid_loader, criterion, optimizer, num_epochs=25)
def evaluate_model(model, data_loader):
model.eval()
all_preds = []
all_labels = []
with torch.no_grad():
for inputs, labels in data_loader:
inputs = inputs.to(device)
labels = labels.to(device)
outputs = model(inputs)
_, preds = torch.max(outputs, 1)
all_preds.extend(preds.cpu().numpy())
all_labels.extend(labels.cpu().numpy())
accuracy = accuracy_score(all_labels, all_preds)
f1 = f1_score(all_labels, all_preds, average='weighted')
return accuracy, f1
train_acc, train_f1 = evaluate_model(model, train_loader)
valid_acc, valid_f1 = evaluate_model(model, valid_loader)
print(f'Train Accuracy: {train_acc:.4f}, Train F1 Score: {train_f1:.4f}')
print(f'Validation Accuracy: {valid_acc:.4f}, Validation F1 Score: {valid_f1:.4f}')
TASK 3:
!pip install opencv-python-headless
!pip install scikit-image
import cv2
import numpy as np
import matplotlib.pyplot as plt
image1 = cv2.imread('image1.png', cv2.IMREAD_GRAYSCALE)
image2 = cv2.imread('image2.png', cv2.IMREAD_GRAYSCALE)
mask1 = cv2.imread('mask1.png', cv2.IMREAD_GRAYSCALE)
mask2 = cv2.imread('mask2.png', cv2.IMREAD_GRAYSCALE)
def load_control_points(file_name):
points = np.loadtxt(file_name)
return points
control_points1 = load_control_points('control_points1.txt')
control_points2 = load_control_points('control_points2.txt')
plt.figure(figsize=(12, 12))
plt.subplot(2, 2, 1)
plt.title('Image 1')
plt.imshow(image1, cmap='gray')
plt.subplot(2, 2, 2)
plt.title('Image 2')
plt.imshow(image2, cmap='gray')
plt.subplot(2, 2, 3)
plt.title('Mask 1')
plt.imshow(mask1, cmap='gray')
plt.subplot(2, 2, 4)
plt.title('Mask 2')
plt.imshow(mask2, cmap='gray')
plt.show()
def register_images_with_control_points(image1, image2, control_points1, control_points2):
src_pts = control_points1[:, :2]
dst_pts = control_points2[:, :2]
M, mask = cv2.findHomography(dst_pts, src_pts, cv2.RANSAC, 5.0)
h, w = image1.shape
aligned_image = cv2.warpPerspective(image2, M, (w, h))
return aligned_image, M
aligned_image, M = register_images_with_control_points(image1, image2, control_points1, control_points2)
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1)
plt.title('Aligned Image')
plt.imshow(aligned_image, cmap='gray')
plt.subplot(1, 2, 2)
plt.title('Mask 1')
plt.imshow(mask1, cmap='gray')
plt.show()
aligned_mask2 = cv2.warpPerspective(mask2, M, (image1.shape[1], image1.shape[0]))
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1)
plt.title('Aligned Mask 2')
plt.imshow(aligned_mask2, cmap='gray')
plt.subplot(1, 2, 2)
plt.title('Mask 1')
plt.imshow(mask1, cmap='gray')
plt.show()
from skimage.metrics import mean_squared_error, structural_similarity
if 'mask1' in locals() and 'aligned_mask2' in locals():
mse = mean_squared_error(mask1, aligned_mask2)
ssim, _ = structural_similarity(mask1, aligned_mask2, full=True)
print(f'Mean Squared Error: {mse}')
print(f'Structural Similarity Index: {ssim}')
else:
print("mask1 or aligned_mask2 is not defined. Please check your variable names and ensure they are loaded correctly.")