Project 2 - EDA on Vehicle Insurance Customer Data
Q1.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

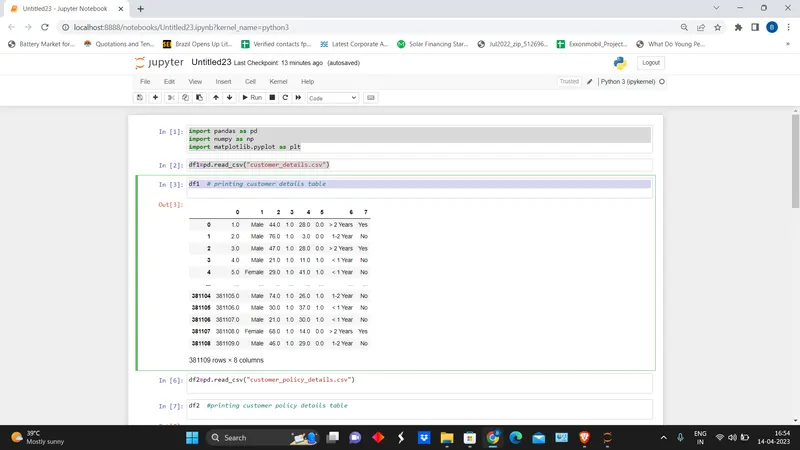
df1=pd.read_csv("customer_details.csv")

df1  # printing customer details table
df2=pd.read_csv("customer_policy_details.csv")

df2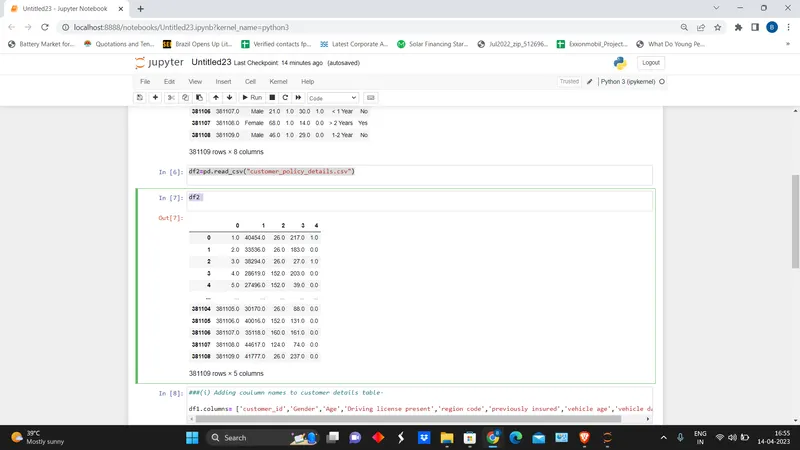
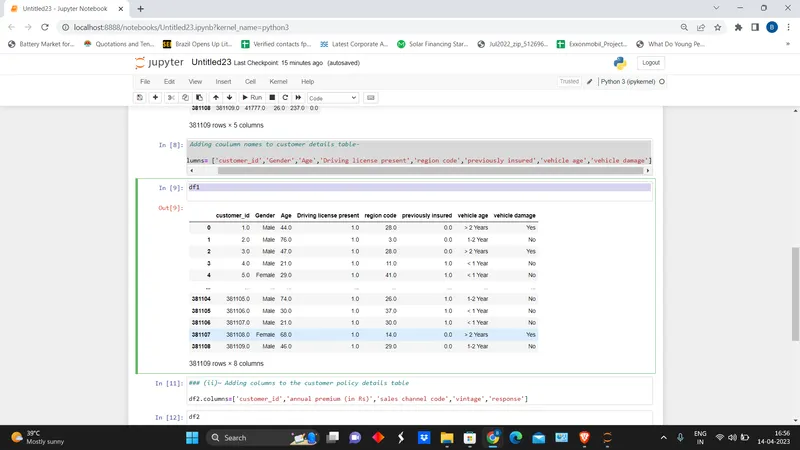
###(i) Adding coulumn names to customer details table-

df1.columns= ['customer_id','Gender','Age','Driving license present','region code','previously insured','vehicle age','vehicle damage']

df1
### (ii)~ Adding columns to the customer policy details table

df2.columns=['customer_id','annual premium (in Rs)','sales channel code','vintage','response']

df2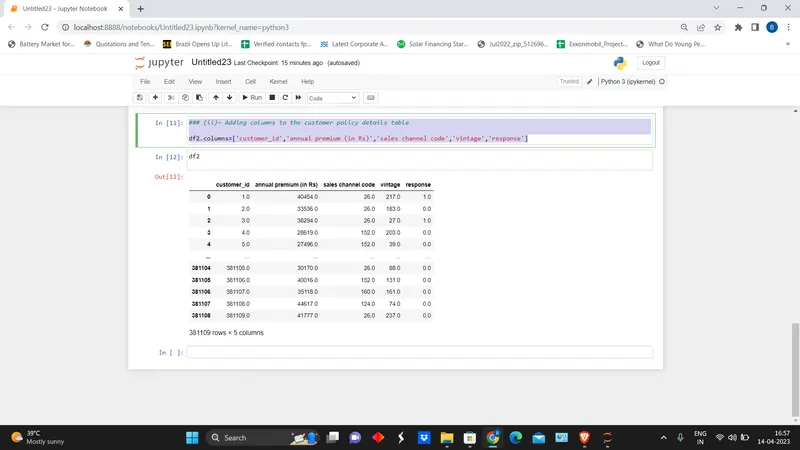
Q2.
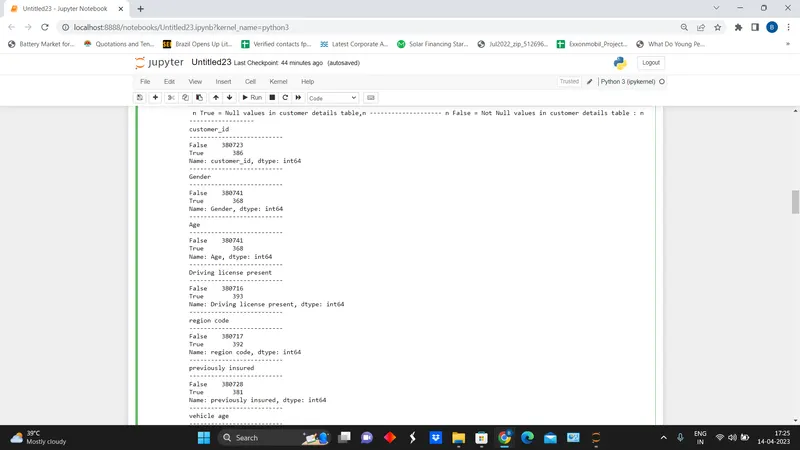
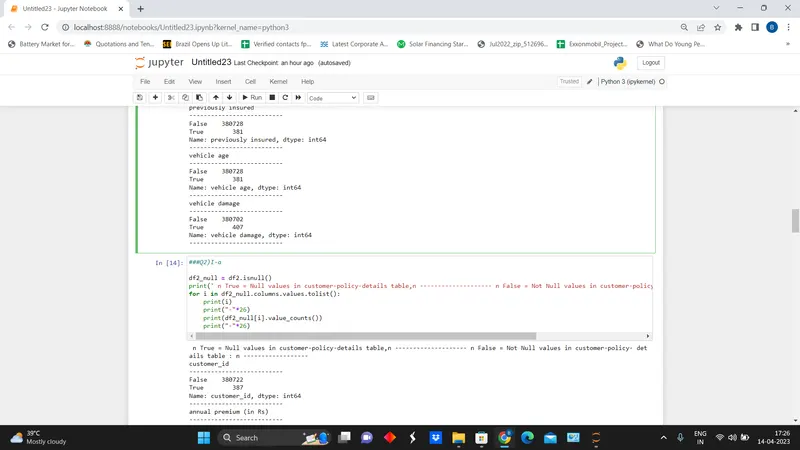
### Q2)i-a

df1_null = df1.isnull()
print(' n True = Null values in customer details table,n -------------------- n False = Not Null values in customer details table : n ------------------')
for i in df1_null.columns.values.tolist():
print(i)
print("-"*26)
print(df1_null[i].value_counts())
print("-"*26)
###Q2)I-a

df2_null = df2.isnull()
print(' n True = Null values in customer-policy-details table,n -------------------- n False = Not Null values in customer-policy- details table : n ------------------')
for i in df2_null.columns.values.tolist():
    print(i)
    print("-"*26)
    print(df2_null[i].value_counts())
    print("-"*26)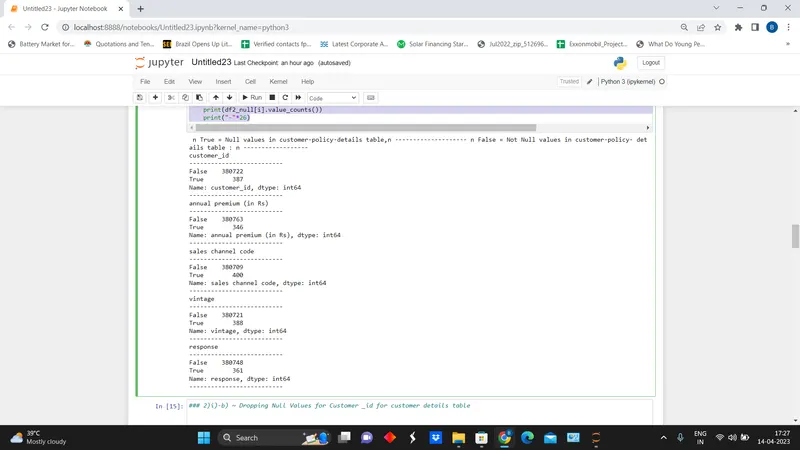
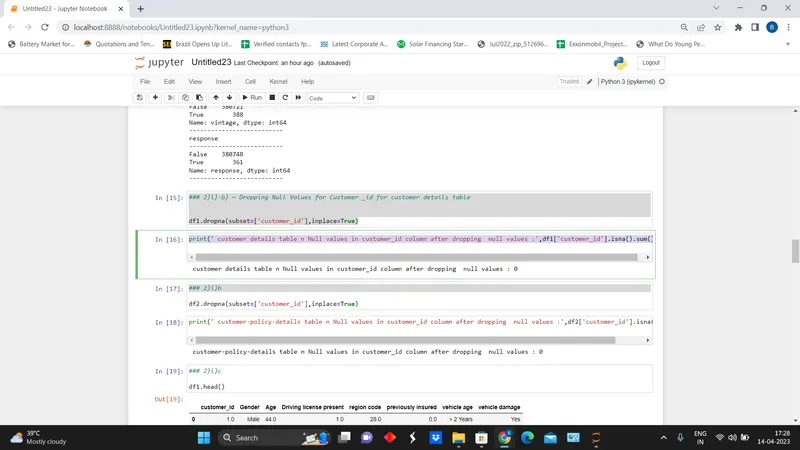
### 2)i)-b) ~ Dropping Null Values for Customer _id for customer details table


df1.dropna(subset=['customer_id'],inplace=True)
print(' customer details table n Null values in customer_id column after dropping null values :',df1['customer_id'].isna().sum())
### 2)i)b

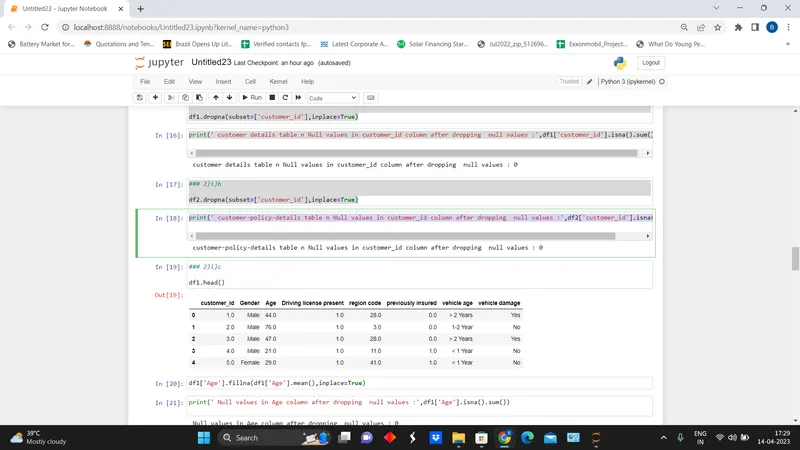
df2.dropna(subset=['customer_id'],inplace=True)

print(' customer-policy-details table n Null values in customer_id column after dropping  null values :',df2['customer_id'].isna().sum())
### 2)i)c

df1.head() 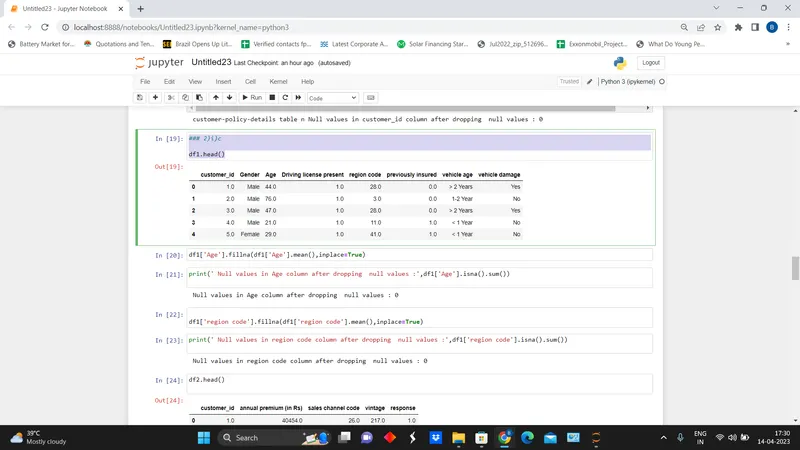
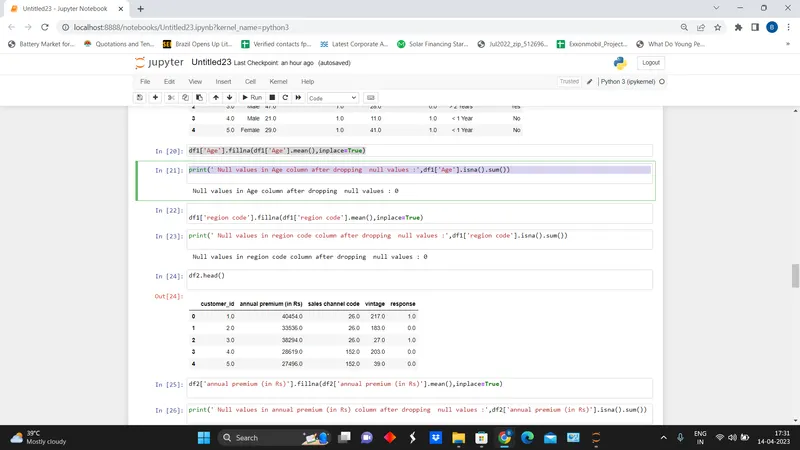
df1['Age'].fillna(df1['Age'].mean(),inplace=True)

print(' Null values in Age column after dropping  null values :',df1['Age'].isna().sum())
df1['region code'].fillna(df1['region code'].mean(),inplace=True)print(' Null values in region code column after dropping null values :',df1['region code'].isna().sum())
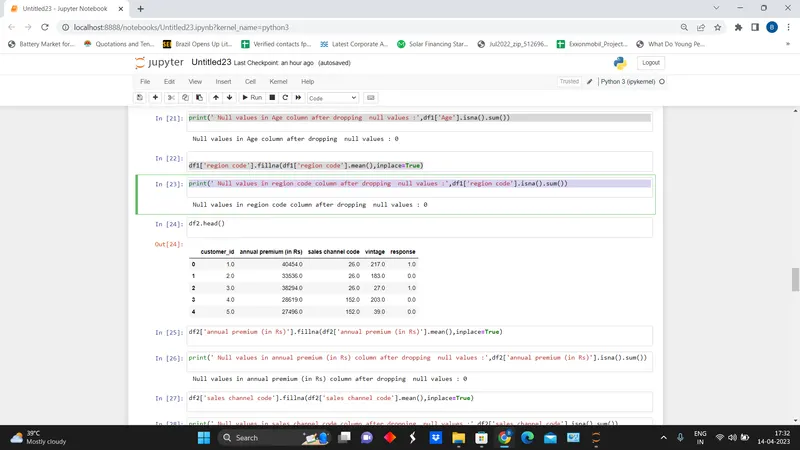
df2.head()
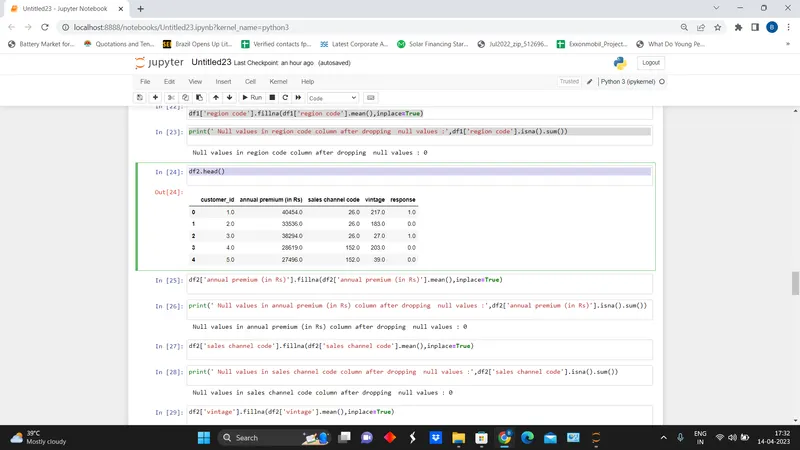
df2['annual premium (in Rs)'].fillna(df2['annual premium (in Rs)'].mean(),inplace=True)
print(' Null values in annual premium (in Rs) column after dropping null values :',df2['annual premium (in Rs)'].isna().sum())
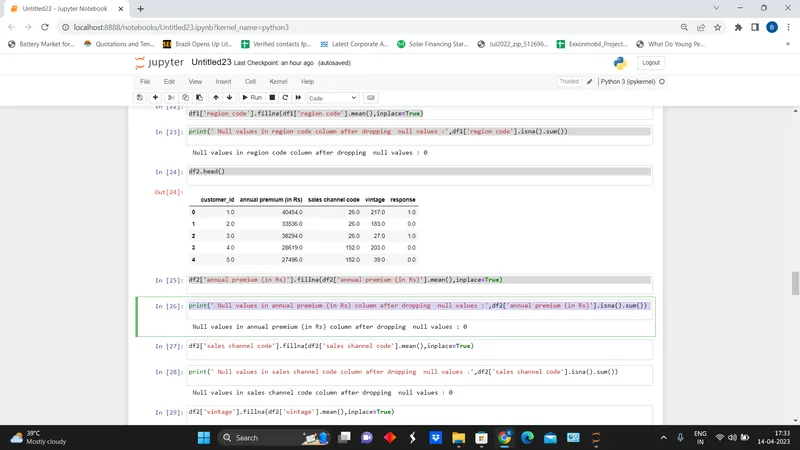
df2['sales channel code'].fillna(df2['sales channel code'].mean(),inplace=True)
print(' Null values in sales channel code column after dropping null values :',df2['sales channel code'].isna().sum())
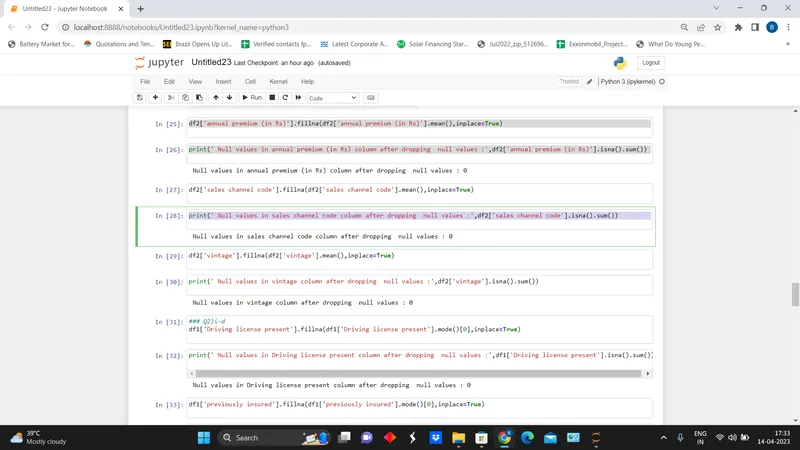
df2['vintage'].fillna(df2['vintage'].mean(),inplace=True)
print(' Null values in vintage column after dropping null values :',df2['vintage'].isna().sum())
### Q2)i-d
df1['Driving license present'].fillna(df1['Driving license present'].mode()[0],inplace=True)
print(' Null values in Driving license present column after dropping null values :',df1['Driving license present'].isna().sum())
df1['previously insured'].fillna(df1['previously insured'].mode()[0],inplace=True)
print(' Null values in previously insured column after dropping null values :',df1['previously insured'].isna().sum())
df2['vintage'].fillna(df2['vintage'].mode()[0],inplace=True)
print(' Null values in previously insured column after dropping null values :',df2['vintage'].isna().sum())
### Q2.(II)-A
df1.describe()
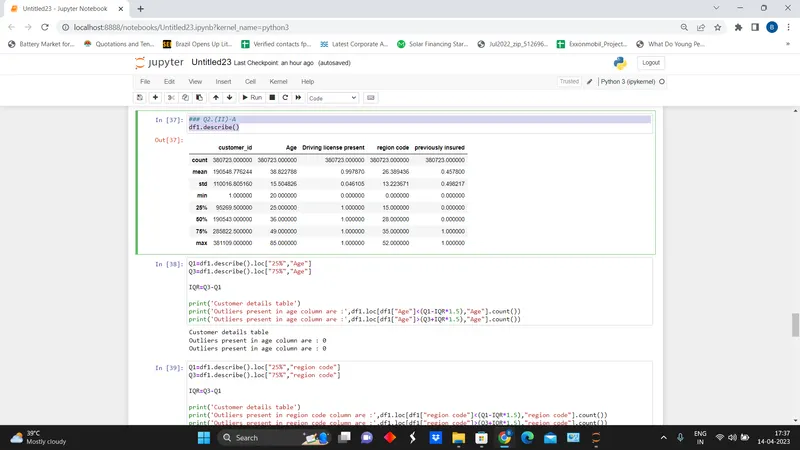
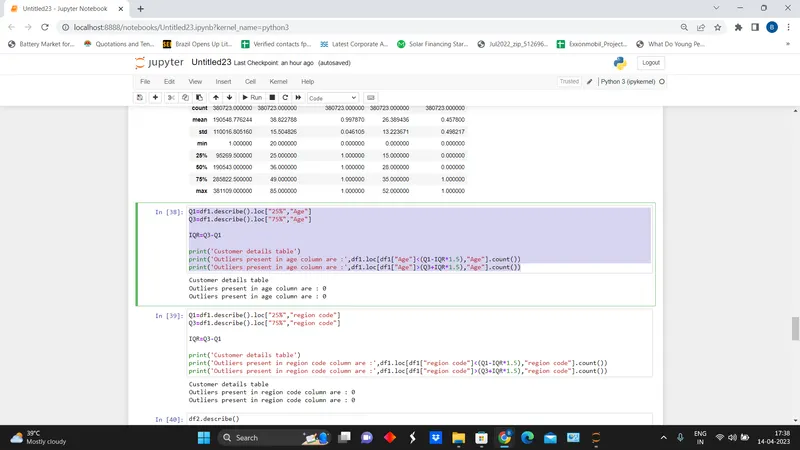
Q1=df1.describe().loc["25%","Age"]
Q3=df1.describe().loc["75%","Age"]
IQR=Q3-Q1
print('Customer details table')
print('Outliers present in age column are :',df1.loc[df1["Age"]<(Q1-IQR*1.5),"Age"].count())
print('Outliers present in age column are :',df1.loc[df1["Age"]>(Q3+IQR*1.5),"Age"].count())
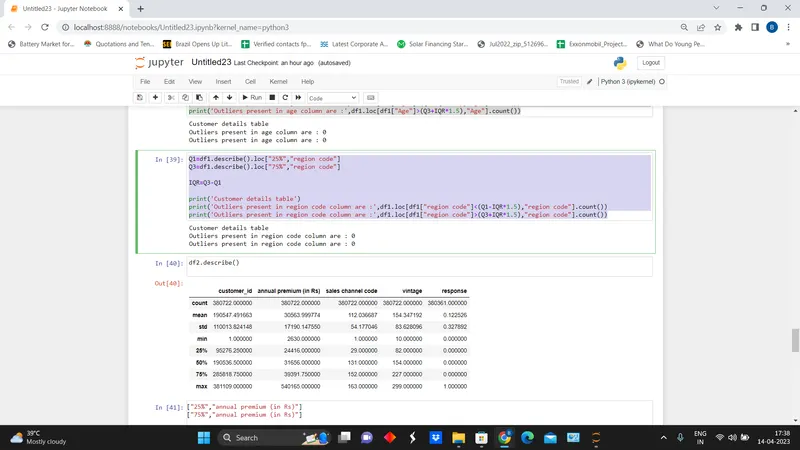
Q1=df1.describe().loc["25%","region code"]
Q3=df1.describe().loc["75%","region code"]
IQR=Q3-Q1
print('Customer details table')
print('Outliers present in region code column are :',df1.loc[df1["region code"]<(Q1-IQR*1.5),"region code"].count())
print('Outliers present in region code column are :',df1.loc[df1["region code"]>(Q3+IQR*1.5),"region code"].count())
df2.describe()
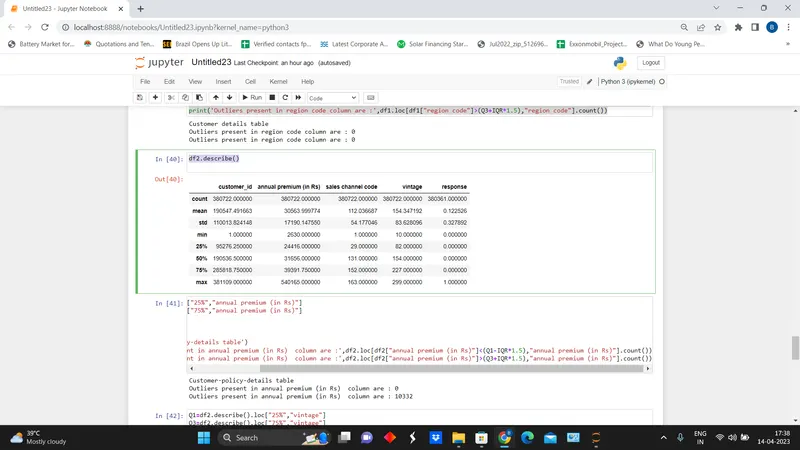
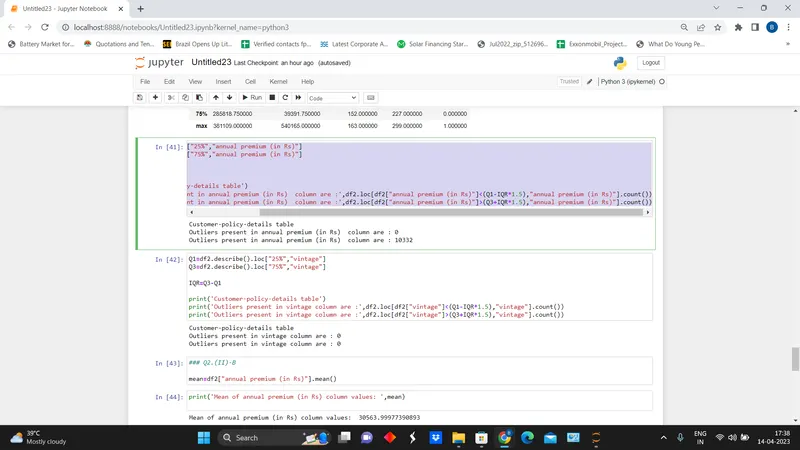
Q1=df2.describe().loc["25%","annual premium (in Rs)"]
Q3=df2.describe().loc["75%","annual premium (in Rs)"]
IQR=Q3-Q1
print('Customer-policy-details table')
print('Outliers present in annual premium (in Rs) column are :',df2.loc[df2["annual premium (in Rs)"]<(Q1-IQR*1.5),"annual premium (in Rs)"].count())
print('Outliers present in annual premium (in Rs) column are :',df2.loc[df2["annual premium (in Rs)"]>(Q3+IQR*1.5),"annual premium (in Rs)"].count())
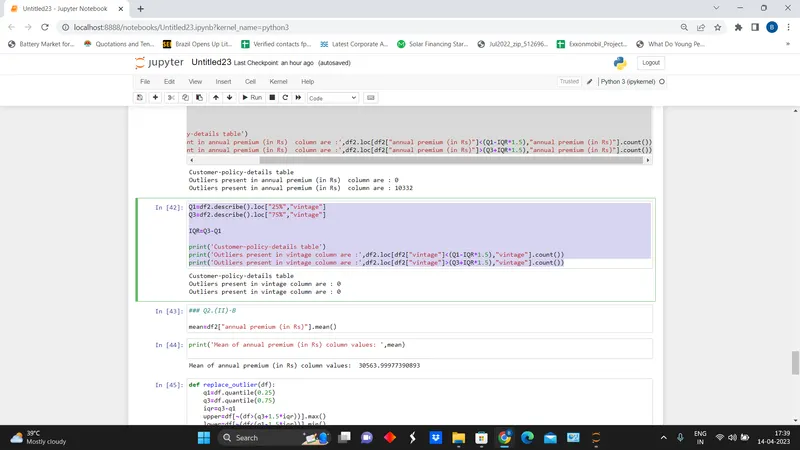
Q1=df2.describe().loc["25%","vintage"]
Q3=df2.describe().loc["75%","vintage"]
IQR=Q3-Q1
print('Customer-policy-details table')
print('Outliers present in vintage column are :',df2.loc[df2["vintage"]<(Q1-IQR*1.5),"vintage"].count())
print('Outliers present in vintage column are :',df2.loc[df2["vintage"]>(Q3+IQR*1.5),"vintage"].count())
### Q2.(II)-B
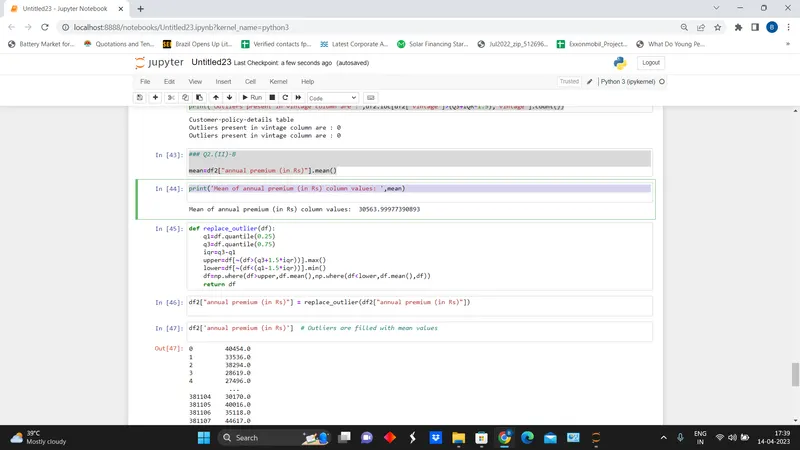
mean=df2["annual premium (in Rs)"].mean()
print('Mean of annual premium (in Rs) column values: ',mean)
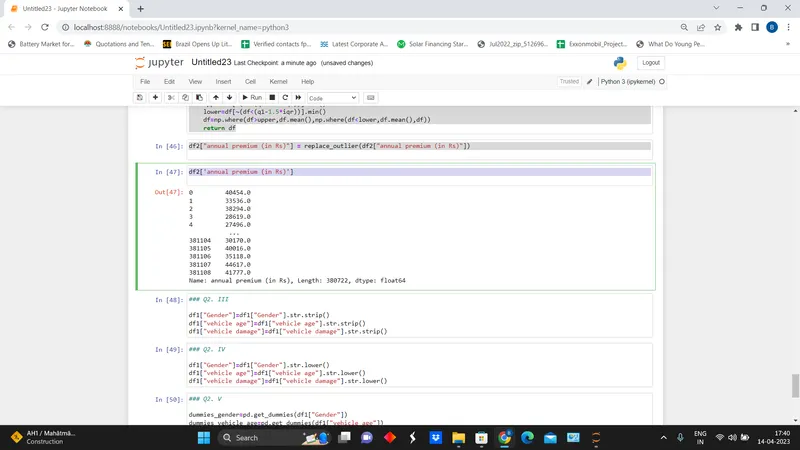
def replace_outlier(df):
q1=df.quantile(0.25)
q3=df.quantile(0.75)
iqr=q3-q1
upper=df[~(df>(q3+1.5*iqr))].max()
lower=df[~(df<(q1-1.5*iqr))].min()
df=np.where(df>upper,df.mean(),np.where(df<lower,df.mean(),df))
return df
df2["annual premium (in Rs)"] = replace_outlier(df2["annual premium (in Rs)"])
df2['annual premium (in Rs)']
### Q2. III
df1["Gender"]=df1["Gender"].str.strip()
df1["vehicle age"]=df1["vehicle age"].str.strip()
df1["vehicle damage"]=df1["vehicle damage"].str.strip()
### Q2. IV
df1["Gender"]=df1["Gender"].str.lower()
df1["vehicle age"]=df1["vehicle age"].str.lower()
df1["vehicle damage"]=df1["vehicle damage"].str.lower()
### Q2. V
dummies_gender=pd.get_dummies(df1["Gender"])
dummies_vehicle_age=pd.get_dummies(df1["vehicle age"])
dummies_vehicle_damage=pd.get_dummies(df1["vehicle damage"])
dummies_dlp=pd.get_dummies(df1["Driving license present"])
dummies_pre=pd.get_dummies(df1["previously insured"])
### 2).(vi)
print(df1.duplicated().sum())
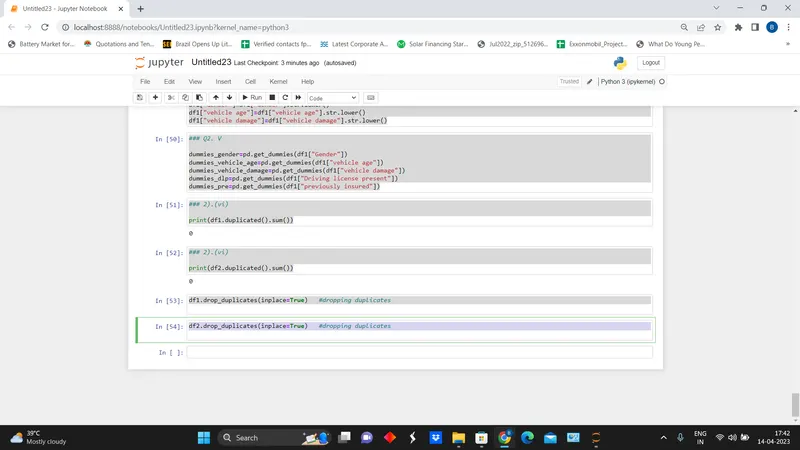
### 2).(vi)
print(df2.duplicated().sum())
df1.drop_duplicates(inplace=True) #dropping duplicates
df2.drop_duplicates(inplace=True) #dropping duplicates
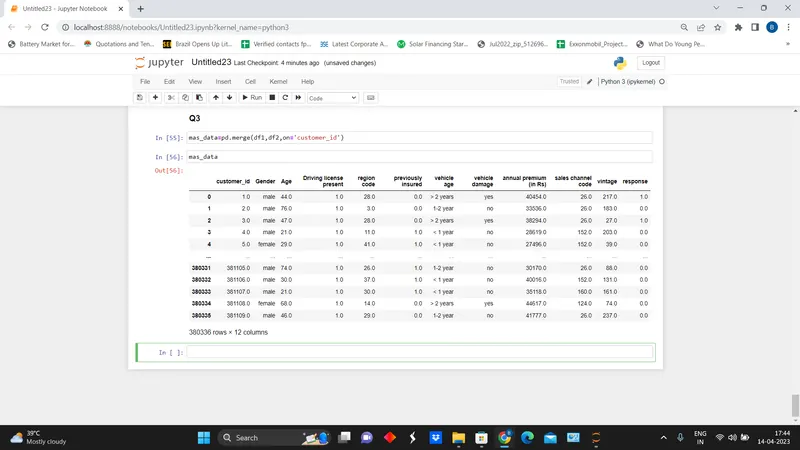
Q3.
mas_data=pd.merge(df1,df2,on='customer_id')
mas_data
Q4.
### I
gwiseanpl=mas_data.groupby(["Gender"])["annual premium (in Rs)"].mean()
gwiseanpl
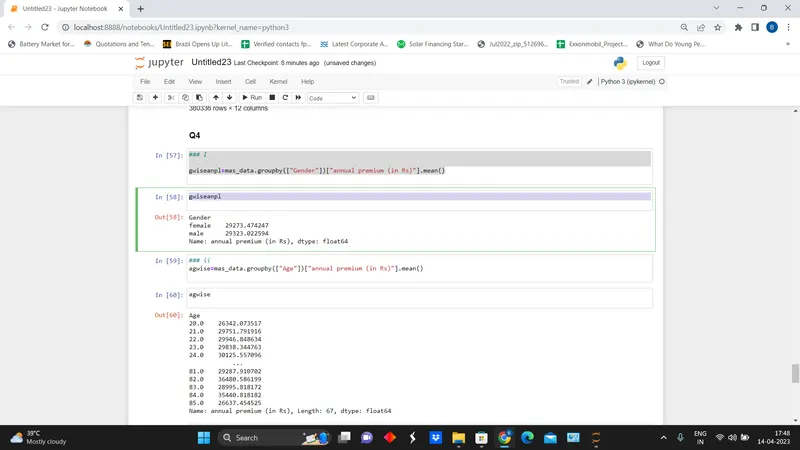
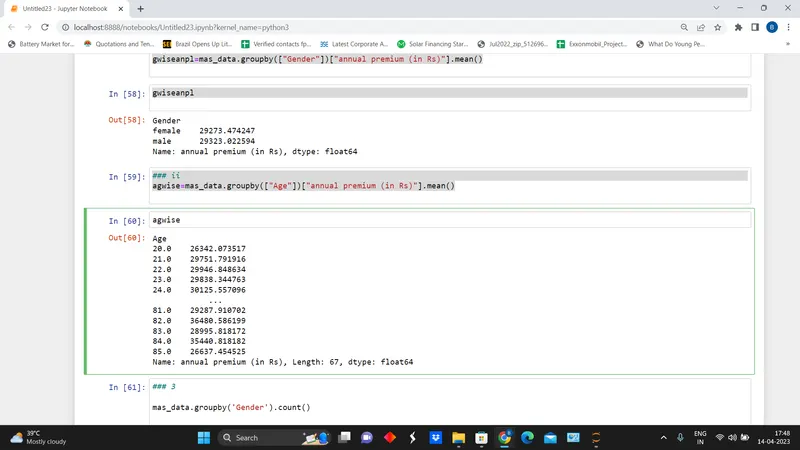
### ii
agwise=mas_data.groupby(["Age"])["annual premium (in Rs)"].mean()
agwise
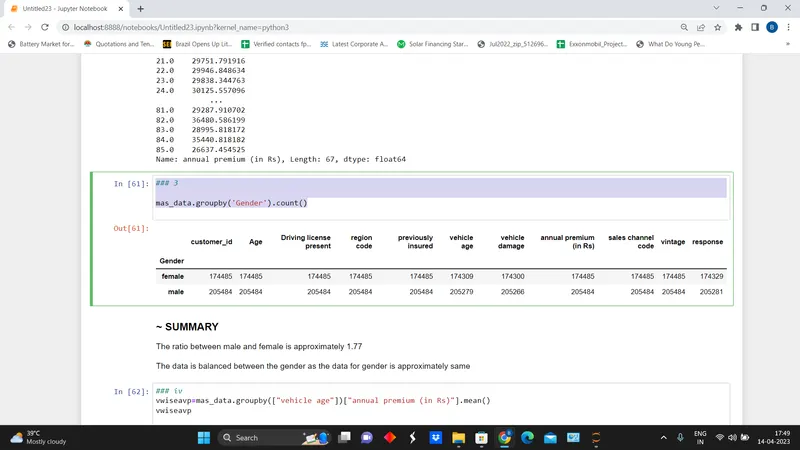
### 3
mas_data.groupby('Gender').count()
### iv
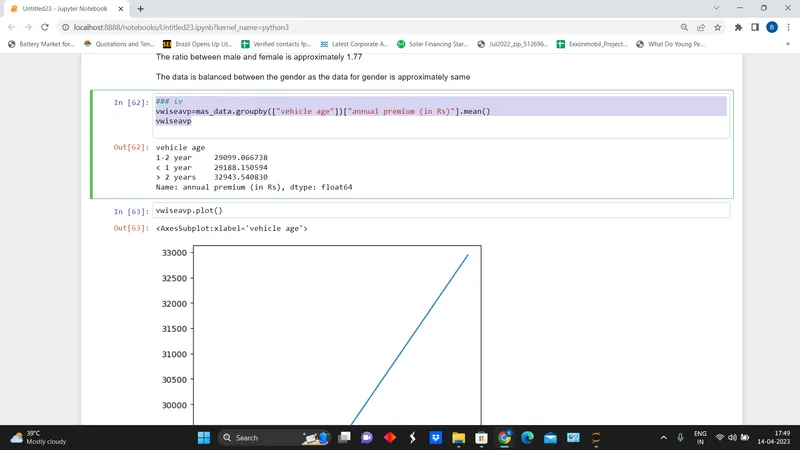
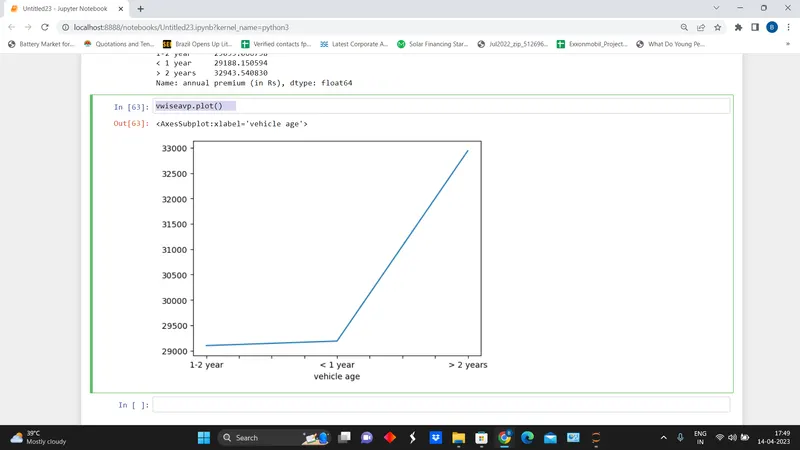
vwiseavp=mas_data.groupby(["vehicle age"])["annual premium (in Rs)"].mean()
vwiseavp
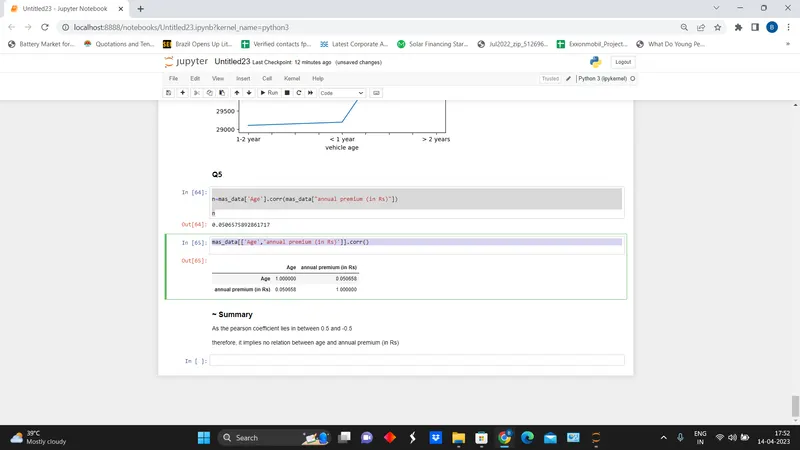
vwiseavp.plot()
Q5.
n=mas_data['Age'].corr(mas_data["annual premium (in Rs)"])
n
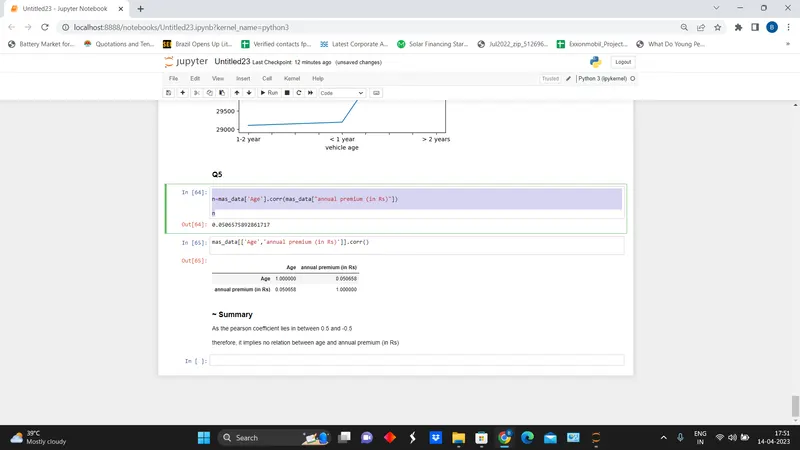
mas_data[['Age','annual premium (in Rs)']].corr()